max / DownloadAllContent
Install steps: Install a userscript manager, select Install, then open a website matched by the script.
Userscript dành cho người mới bắt đầu HOWTO Chrome Edge Firefox
Source and freshness
The following figures come from the original source and are separate from activity on this site.
Original script: 怠惰小说下载器
Source version: 2.8.3.19
Last source check:
Last successful check:
- Source daily installs
- 15
- Source total installs
- 177890
- Source rating
- 96.1
- OpenUserJS install requests
- 30
Requests received by this site are not proof that a user completed installation.
Clicking Install records a request on this site; it does not confirm installation. Not working after install? View troubleshooting and issues
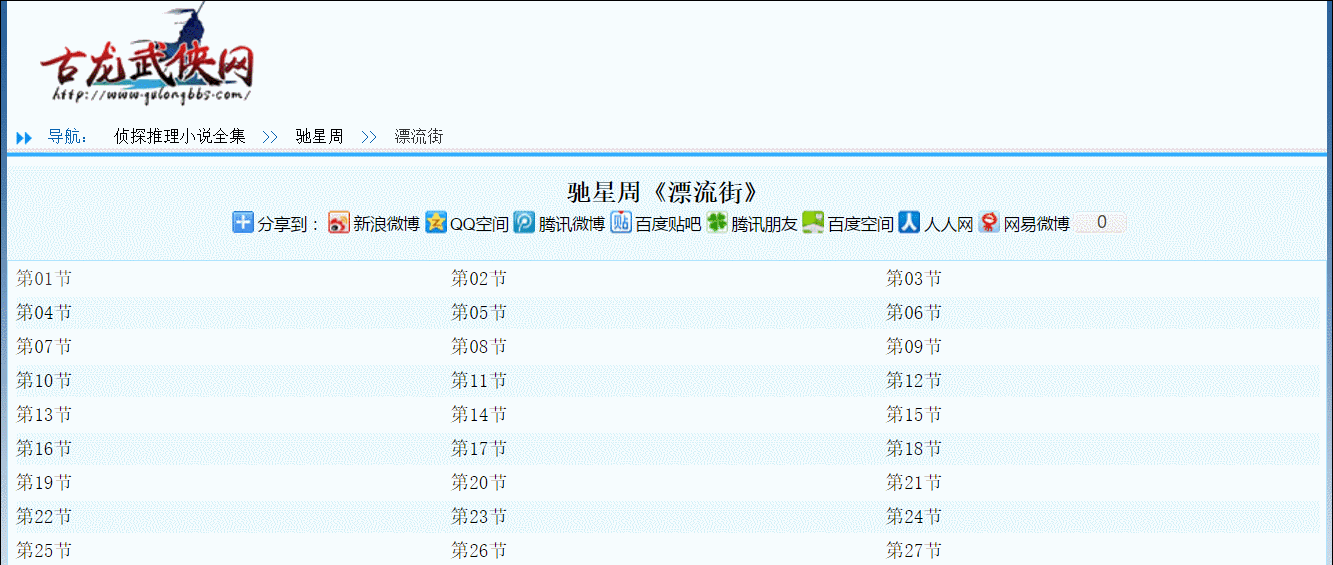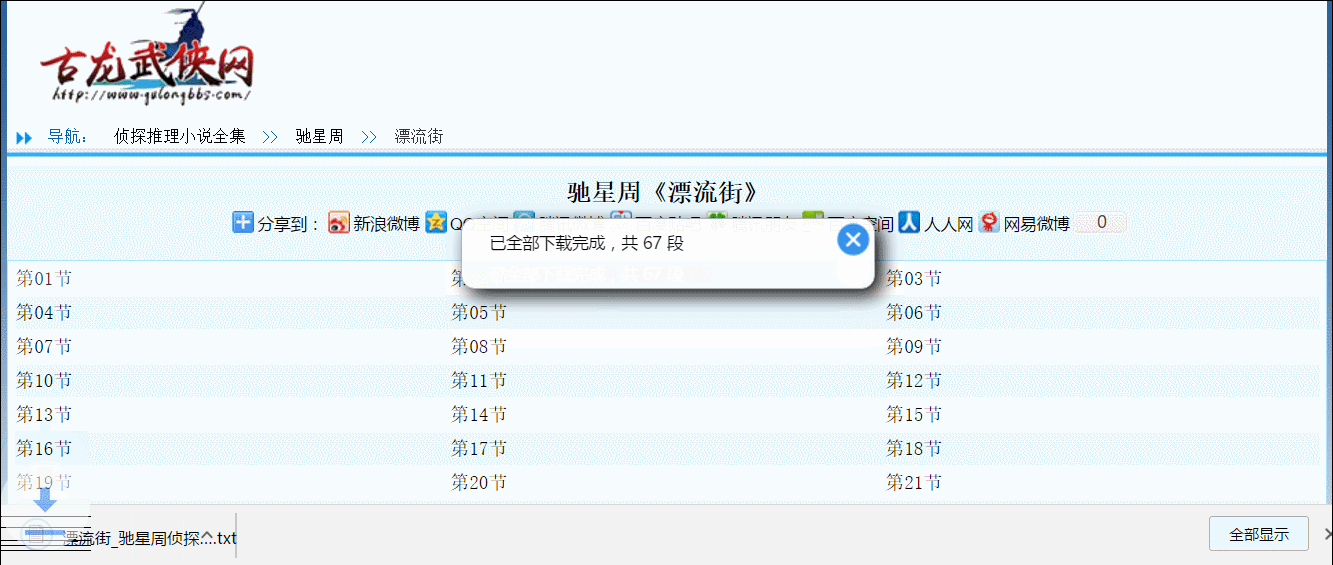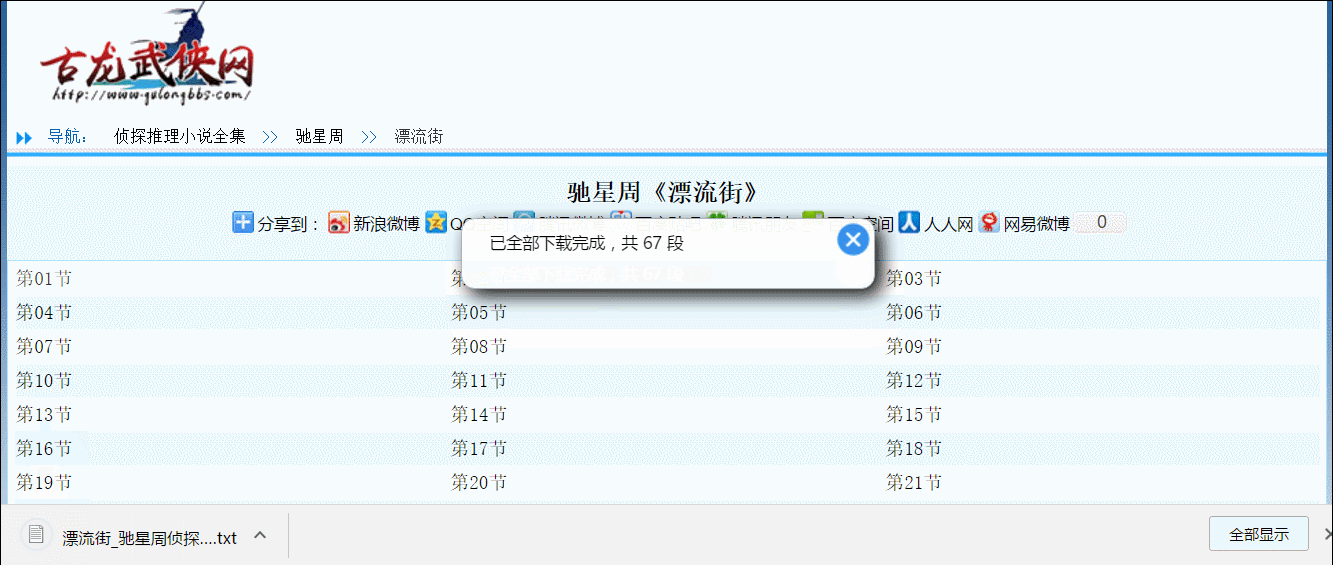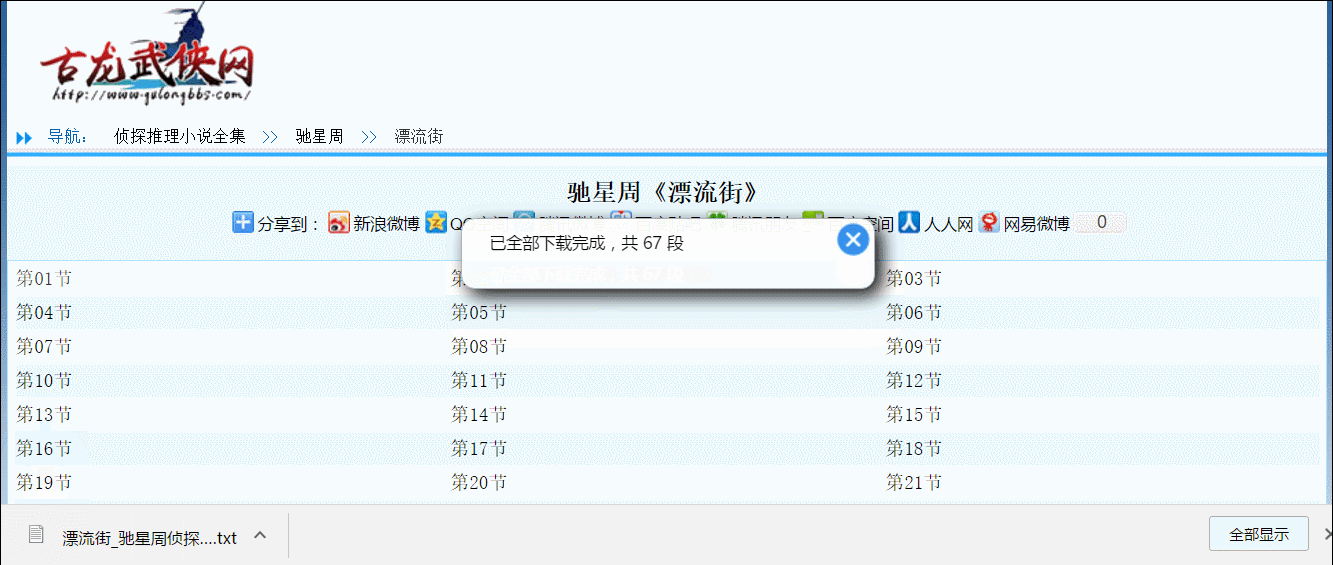
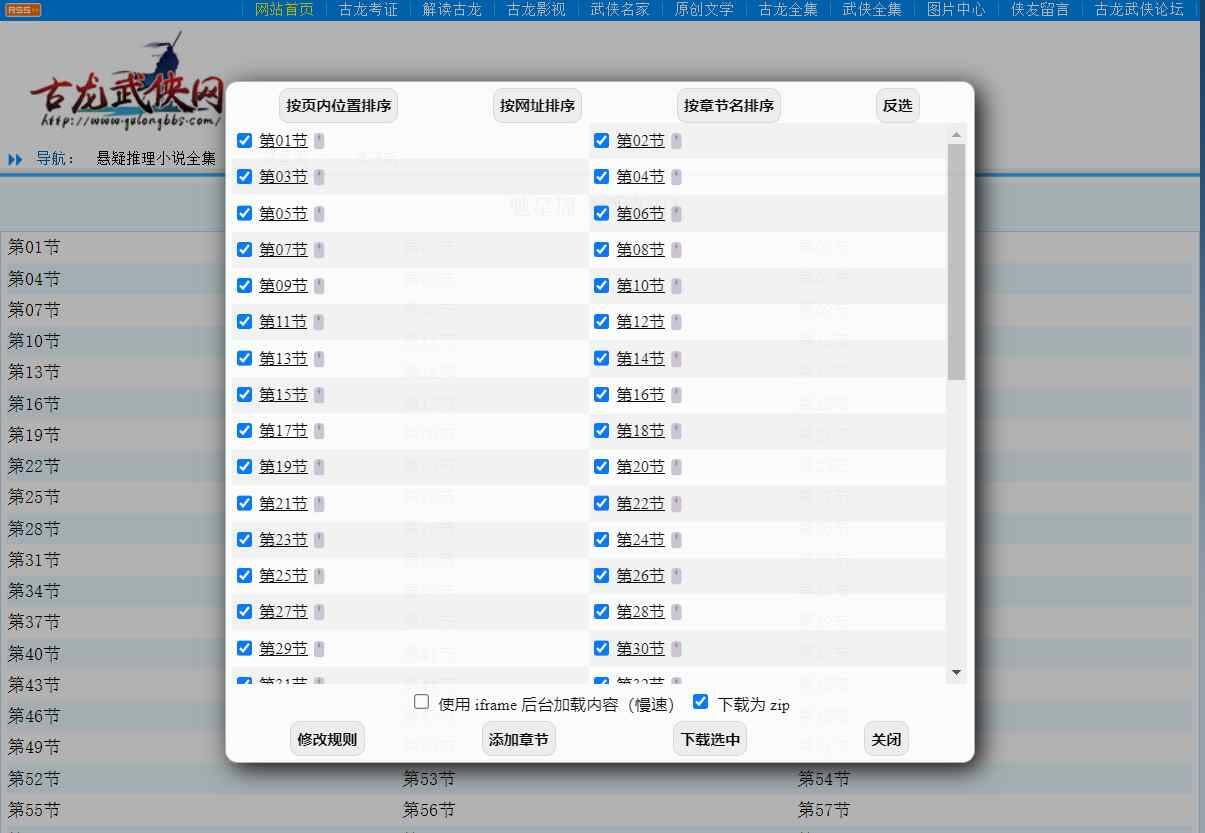
起点晋江红袖书旗番茄等版权站都推荐用【小说】下载脚本 或 小说下载器,无人适配的小站再考虑我的。
切勿用于版权站,如造成侵权或对象站点损失,后果自负。
轻量级抓取脚本,用于下载网页小说或其他文字内容,理论上通用于任何静态写入正文的小说网站、论坛、贴吧等而无需规则。
脚本会自动检索页面中的主要内容并下载(省得复制完gal攻略还要手动逐条删除“某某某13级头衔水龙王发表于X年X月X日来自XX客户端”)。
如果位于小说目录页脚本则会遍历所有章节并排序拼接后存为TXT文档。

操作说明
- 打开小说目录页或其他任意页面
- 按下
CTRL + F9或使用脚本管理器的命令菜单 - 亦可按下
SHIFT + CTRL + F9忽略目录,仅下载当前页 - 如遇目录页分页,可用东方永页机翻完所有目录后再开始下载
- 下载 Calibre 并安装。本文以 3.22.1 Windows 版为例。
- 在主界面点击“偏好选项”。如果默认没有显示,请将窗口最大化或点击工具栏最右侧的双箭头展开
- 点击 “格式转换” - “常用选项”。
- 点击 “内容目录”,在 “Xpath 表达式” 选项框中依次输入 //h:h1 //h:h2 //h:h3 并 “应用”
- 回到主界面,点击 “添加书籍”,选择需要转换的 md 文件,导入。
- 点击 “转换书籍”,确认输出格式为 “EPUB” 或者 “MOBI”,点击确定开始转换。
也可以直接使用在线 md 转 epub
已适配站点规则在下面【简易自定义例子】处,自行复制取用。若是遇到下载出错以及动态加载文本的站点,可提交 issue 至 Github,我若恰好有空可帮你尝试编写自定义规则。亦可加入 Discord 群组 寻求网友帮助。
注:若是其他小说下载器已适配或者列入 todo 列表,或是我认为适配该站会带来律师函之类的麻烦,则适配请求将被忽略。
怠惰小说下载器 ZIP 扩展 下载时分章节保存 TXT 并打包为 ZIP
.
.
.
.
.
.
.
.
.
.
怠惰心法
此功共有七层,以第一层最易,第七层最难。
第一层心法(极易)
CTRL+F9 就完事了呗。
第二层心法(超易)⭐
- 例1:
众神的风车01 - 例2:
众神的风车01!02!03,风车的众神!铁幕
倘若章节链接没有xx章、xx节、xx话之类的特征字样,可点击脚本管理器命令菜单里的自定义下载,输入其中任意一个章节链接包含的字眼下载即可。
例如 “第1部-双星启辰”,即可标记所有相同层级的链接为目录章节并下载。
假如页面有两套章节格式,也可标记多个,例如“众神的风车,风车的众神”。
亦可标记排除项,例如“众神的风车01!02!03,风车的众神!铁幕”,代表标记“众神的风车01”同级链接并排除含有 02 的项和含有 03 的项,同时标记“风车的众神”同级链接并排除含有“铁幕”的项。
第三层心法(略易)
- 例:
众神的风车@@articles@@articlescontent
如果内页没有正文,但章节链接与真实内容链接有关联,可通过自定义下载,替换链接内容获取真实内容。
例如 【众神的风车@@articles*@@*articlescontent】,即可替换章节 URL 中的 articles 为 articlescontent 并自动获取内容。
第四层心法(略难)
- 例:
众神的风车@@articles(\d+)@@articlescontent_$1b
如果链接无法由直接替换得到最终地址,可用正则替换。
例如【众神的风车@@articles(\d+)@@articlescontent_$1b】,即可替换章节 URL 中的 articles1、articles2 为
articlescontent_1b、articlescontent_2b
第五层心法(难)
- 例1:
.l_chaptname>a - 例2:
.l_chaptname>a>>item.innerText=`第${window.a++}章 ${item.innerText}`;return item;
输入章节的 css 选择器可以更精确地标记章节链接。
例如.l_chaptname>a,代表 class 为 l_chaptname 的元素下的 a 链接。
可使用>>管道来处理抓取到的item。如item.innerText=`第${window.a++}章 ${item.innerText}`;return item;
下载内容可能含有干扰码,此时只需点击懒人小说下载设置,输入干扰码的 css 选择器即可排除干扰码。
例如 .mask,.ksam,font.jammer,代表删除 class 为 mask 或者 ksam 的元素或者 class 为 jammer 的 font 元素。
第六层心法(超难)
- 例1:
.l_chaptname>a@@@@@@@#content - 例2:
众神的风车@@@@@@var noval=JSON.parse(data.querySelector("#meta-preload-data").content).novel;noval[Object.keys(noval)[0]].content;
倘若正文不在内页正文,是页面加载后处理得到的,可点击自定义下载,输入自定义代码对内页进行分析获取正确结果。
例如 【众神的风车@@@@@@var noval=JSON.parse(data.querySelector("#meta-preload-data").content).novel;noval[Object.keys(noval)[0]].content;】,即可通过自定义代码处理返回页面获取内容。
代码中使用 data 可以获得返回页面的 document,最后一个表达式的值为最终写入的内容。
如果返回 false,代表异步回调,可自行抓取内容并等待抓取成功后用 cb(content) 返回抓取到的 content。
可以使用@选择器的方式简化抓取指定元素内容。例如【众神的风车@@@@@@@#content】。
倘若章节没有链接,点击后方才生成链接跳转,可通过 >> 管道处理抓取到的元素生成章节链接,详情见下方例子。
第七层心法(24K纯难)
倘若正文已经经过加密,需要解密才能获取正确内容,可打开浏览器的控制台,自定义 dacProcess 函数,调取页面中网站自身的解密代码处理抓取的加密数据。
例如控制台输入dacProcess=data=>{return decrypt(xxx);} 代表调用网站的 decrypt 解密章节页面返回的数据。然后再点击自定义下载,需要注意自定义下载时标记章节是必需的。
完整格式说明
某个章节名/CSS选择器【选择器后可跟>>传入item添加处理代码】 @@ 抓取到链接的正则匹配 @@ 对应匹配生成替换URL @@ 根据爬取返回内容data处理并返回最终文本
赞助
恰好对你有帮助的话,可请杯奶茶 ❤️爱发电,或者将此脚本推荐给你的朋友加入Discord群组寻求帮助。也可以来小众论坛找我玩啊。
|
关注微信公众号
不用担心,你也可以不关注,不会有什么“关注公众号才能解锁的隐藏功能”但脚本终有一天会失效,与可信的作者保持联系总是有价值的。
 如有需要,支付前扫此二维码可获小额支付红包
FAQ
关于配置项
【以下功能需要通过 Tampermonkey 等管理器的命令菜单进入】

- 自定义目录:如https://xxx.xxx/book-[20-99].html,https://xxx.xxx/book-[01-10].html,意思为下载book-20.html到book-99.html,以及book-01.html到book-10.html,使用[1-10]则不补0。
- 章节选择器自定义:输入章节链接的 css 选择器即可,后面可以接上 url 替换码、以及自定义处理代码。
- 干扰码:填入干扰码的 css 选择器,如
.mask,.ksam,意为删除 class 为 mask 或者 ksam 的元素。 - 按标题名重新排序:是则把目录页所有链接按标题名排序后存入txt,否则按页面位置顺序排列。
- 下载线程数:同时下载的线程数,默认为20,遇到存在限制的站点(例如下载时总有章节获取失败)可调低。
简易自定义例子,打开目录页点击【自定义下载】粘贴即可使用
仅作为示例,如果网站改版导致失效,可自行摸索修改
- po18,章节的选择器为 .l_chaptname>a ,输入并下载后发现通过 url 无法下载正文内容,正文是 ajax 通过 articlescontent 下载的。此时可后接 @@articles@@articlescontent (@@ 分隔) 将章节 url 中的 articles 替换为 articlescontent 。 粘贴进命令菜单即可下载。其中第一个 articles 可使用正则,例如 @@articles(\d+)@@$1content 代表将链接中的「articles1」「articles2」等替换为「1content」「2content」。
.l_chaptname>a@@articles@@articlescontent
如果需要下载已购买的vip章节,用这个规则a.btn_L_blue>>let a=document.createElement("a");a.innerText=item.parentNode.parentNode.querySelector('.l_chaptname').innerText;a.href=item.href;return a;@@articles@@articlescontent - pixiv,p站小说的章节选择器为main>section ul>li>div>a,无需替换链接,因此后两项留空。有6个@了 😂。正文在meta里,需要自定义代码提取meta-preload数据的content项。其中 "data" 代表抓取网页的document对象,若返回的是纯文本,则用 data.body.innerText 获取。
main>section ul>li>div>a@@@@@@var noval=JSON.parse(data.querySelector("#meta-preload-data").content).novel;noval[Object.keys(noval)[0]].content; - 其他规则前往 Github 查看
测试网页
- http://www.gulongbbs.com/zhentan/bdlr/plje/Index.html
- http://www.jhshe.com/thread-1837-1-1.html
- http://tieba.baidu.com/p/4871634479
常见问题
- 章节没有“第几章第几节”的字样怎么办?
参考第二层心法输入其中一个章节名即可 - 成功下载一定数量章节后抓取超时失败怎么办?
可能是网站限制了并发数,在设置中调低线程数即可。设为正数代表线程数,负数则代表单线程且间隔x秒下载一章,例如-2代表每隔2秒下载一章 - 按下快捷键没有反应怎么办?
可能是快捷键被其他应用接管了,使用脚本管理器中的命令菜单下载即可 - 有无关干扰字符怎么办?
设置里输入干扰码css选择器即可,多个选择器用逗号分隔 - 章节顺序不对怎么办?
默认是按网页内出现位置排序。点击设置,尝试更改为“按网址重新排序”或者“按章节名重新排序”即可 - 章节标题有误怎么办?
默认是取章节链接文字为标题,可以在设置中自定义章节标题,输入 title 即为抓取分页页面的标题,输入 h1 即为抓取分页页面 h1 级别的文章标题 - 抓取失败是什么原因?
NETWORK ERROR 说明网络错误,可能是当前本机网络故障,也可能是被目标网站封禁了 IP。 TIMEOUT 说明访问超时,可能是因为当前网络速率过慢或者目标网站流量超限。建议更换 IP 后尝试下载。 - 其他问题欢迎通过 email 联系我,恰有空且心情好时可帮你解决。
为啥要写这个脚本?
主要是 因为我要下载驰星周的漂流街,却发现前人的轮子“【小说】下载脚本”不能用,又不想为这破站 🙃 写规则,而且
我就是看不上霸道总裁修仙穿越你咬我啊指不定它三天两头改个版呢。写个通用规则的脚本,一来可以不用追着数不清的小说站适配修改更新,二来也免去了法律风险。
这个脚本会自动去查找主要内容并下载,不需要写规则。当然如果你家网站广告内容比正文还多我也没办法。
遇到特殊网站还是建议用“【小说】下载脚本”。


Đánh giá: 96.1